Hybrid RAG
Vector + BM25 Search EngineHybrid RAG System
사내 문서를 AI가 정확히 찾아 답변하는 하이브리드(Vector+BM25+Graph) 검색 + 문서 전처리 시스템
- PostgreSQL 17
- VectorChord
- BM25
- Graph Search
- FastAPI
- LangGraph
- FlashRank
- OCR-LLM
-
ProjectHybrid RAG System
-
Period2026.02 ~ 2026.05
-
TypeSearch Engine / RAG Backend
-
Role아키텍처 설계 · 백엔드 개발 (3인 팀)
- 고객사
- 싸이버로지텍
- 프로젝트 유형
- RAG Backend / Hybrid Search + 문서 전처리
- 기술 스택
- PostgreSQL 17, VectorChord, BM25, Graph Search, FastAPI, LangGraph, FlashRank, OCR-LLM
- 검색 방식
- Vector (Cosine) + BM25 (Keyword) + Graph 병렬 Hybrid Search
- 랭킹 알고리즘
- RRF (k=60) Fusion + FlashRank Reranking
- 특수 기술
- VectorChord RaBitQ 인덱스, Bert 토크나이저 · 검색 p95 380ms → 90ms · 인덱스 메모리 1/4
- 문서 전처리
- OCR-LLM, Office to md 변환 → Chunk 단위 임베딩
- 신뢰도 보완
- RAG 검색과 별개로 md 문서를 LLM이 직접 읽어 2중 보완
- 검색 성능
- 골든셋 300 기준 Top-5 정답률 0.62 → 0.81 (Vector 0.71 → +BM25·RRF 0.84 → Cross-Encoder)
- 운영 성과
- 문서 12,480건 색인 · 현업 1,200명 · 일 640건 · 답 찾는 시간 20분 → 1분
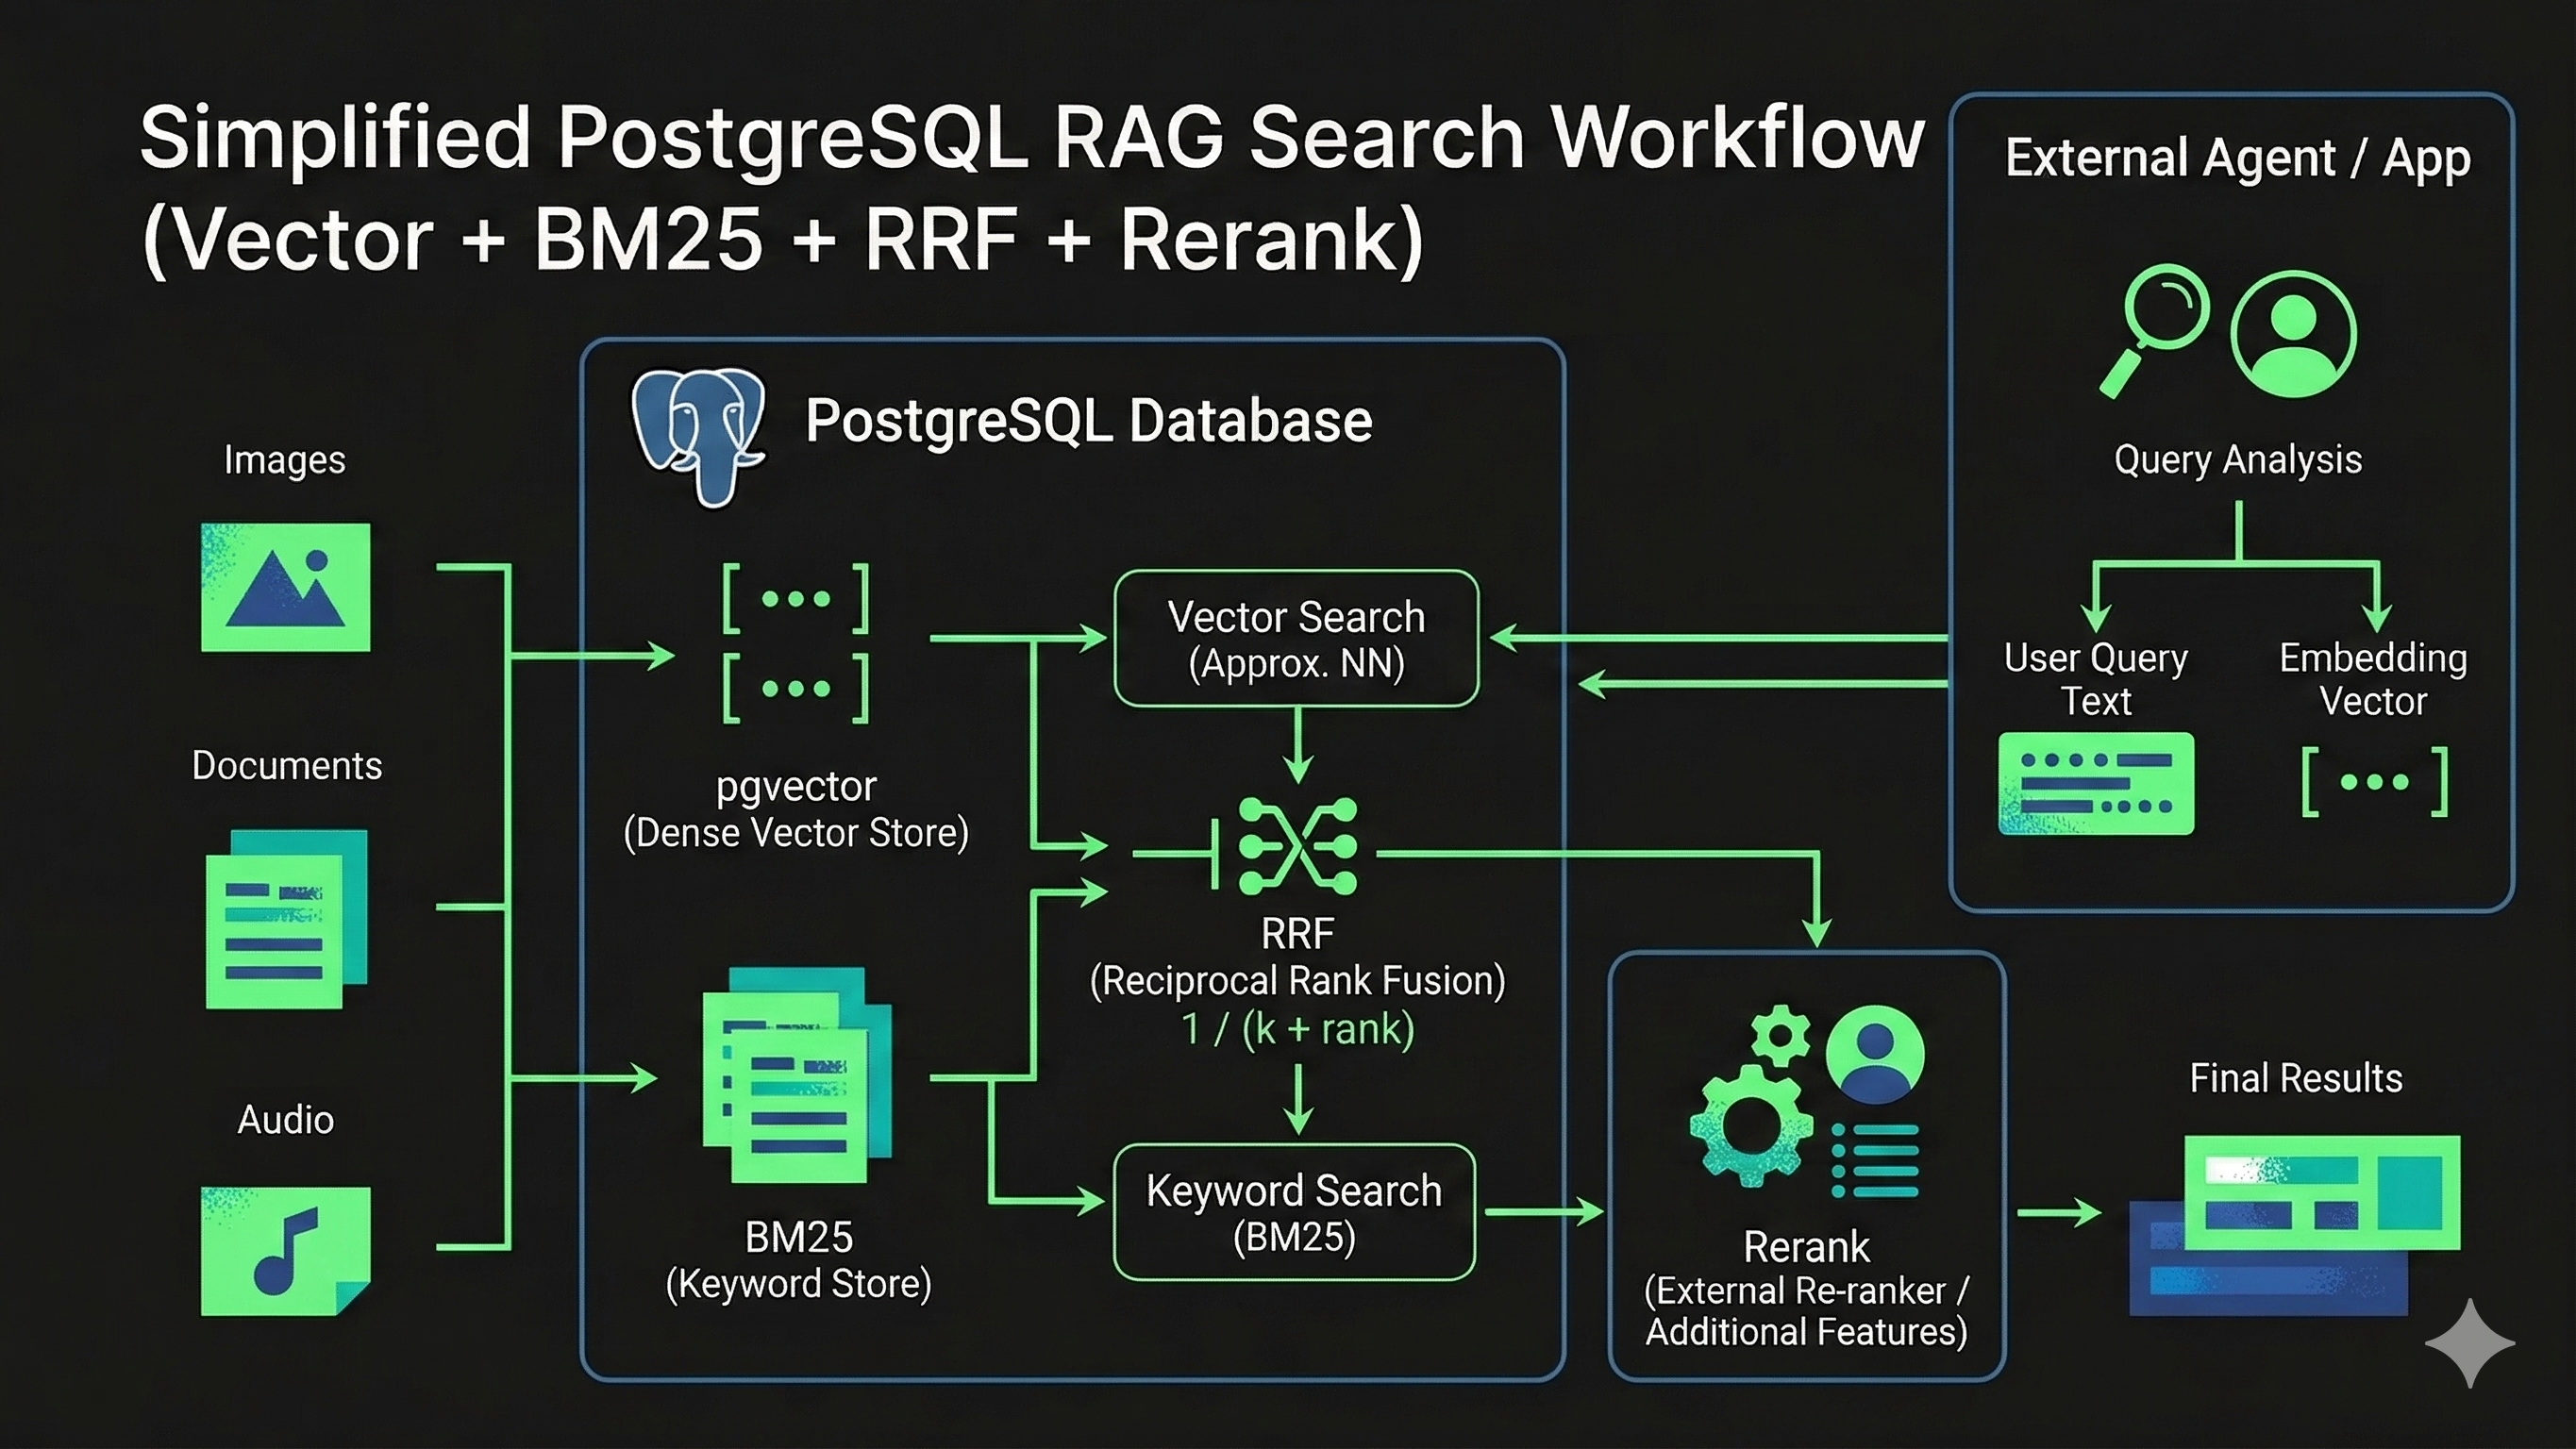
Architecture
Overview
사내 문서 검색 시스템에서 Vector 검색만으로는 키워드 매칭이 누락되고, BM25만으로는 의미적 유사성을 잡지 못하는 한계가 있었습니다. 두 방식 모두 단독으로는 검색 정확도를 보장할 수 없었습니다.
이를 해결하기 위해 Vector + BM25 + Graph 3종 병렬 검색에 RRF 결합과 Cross-Encoder 리랭킹을 더한 하이브리드 파이프라인을 설계했습니다. 또한 OCR-LLM과 Office to md 변환으로 비정형 문서까지 Chunk 단위로 임베딩하고, RAG와 별개로 md 문서를 LLM이 직접 읽어 신뢰도를 2중 보완하는 구조를 구축했습니다.
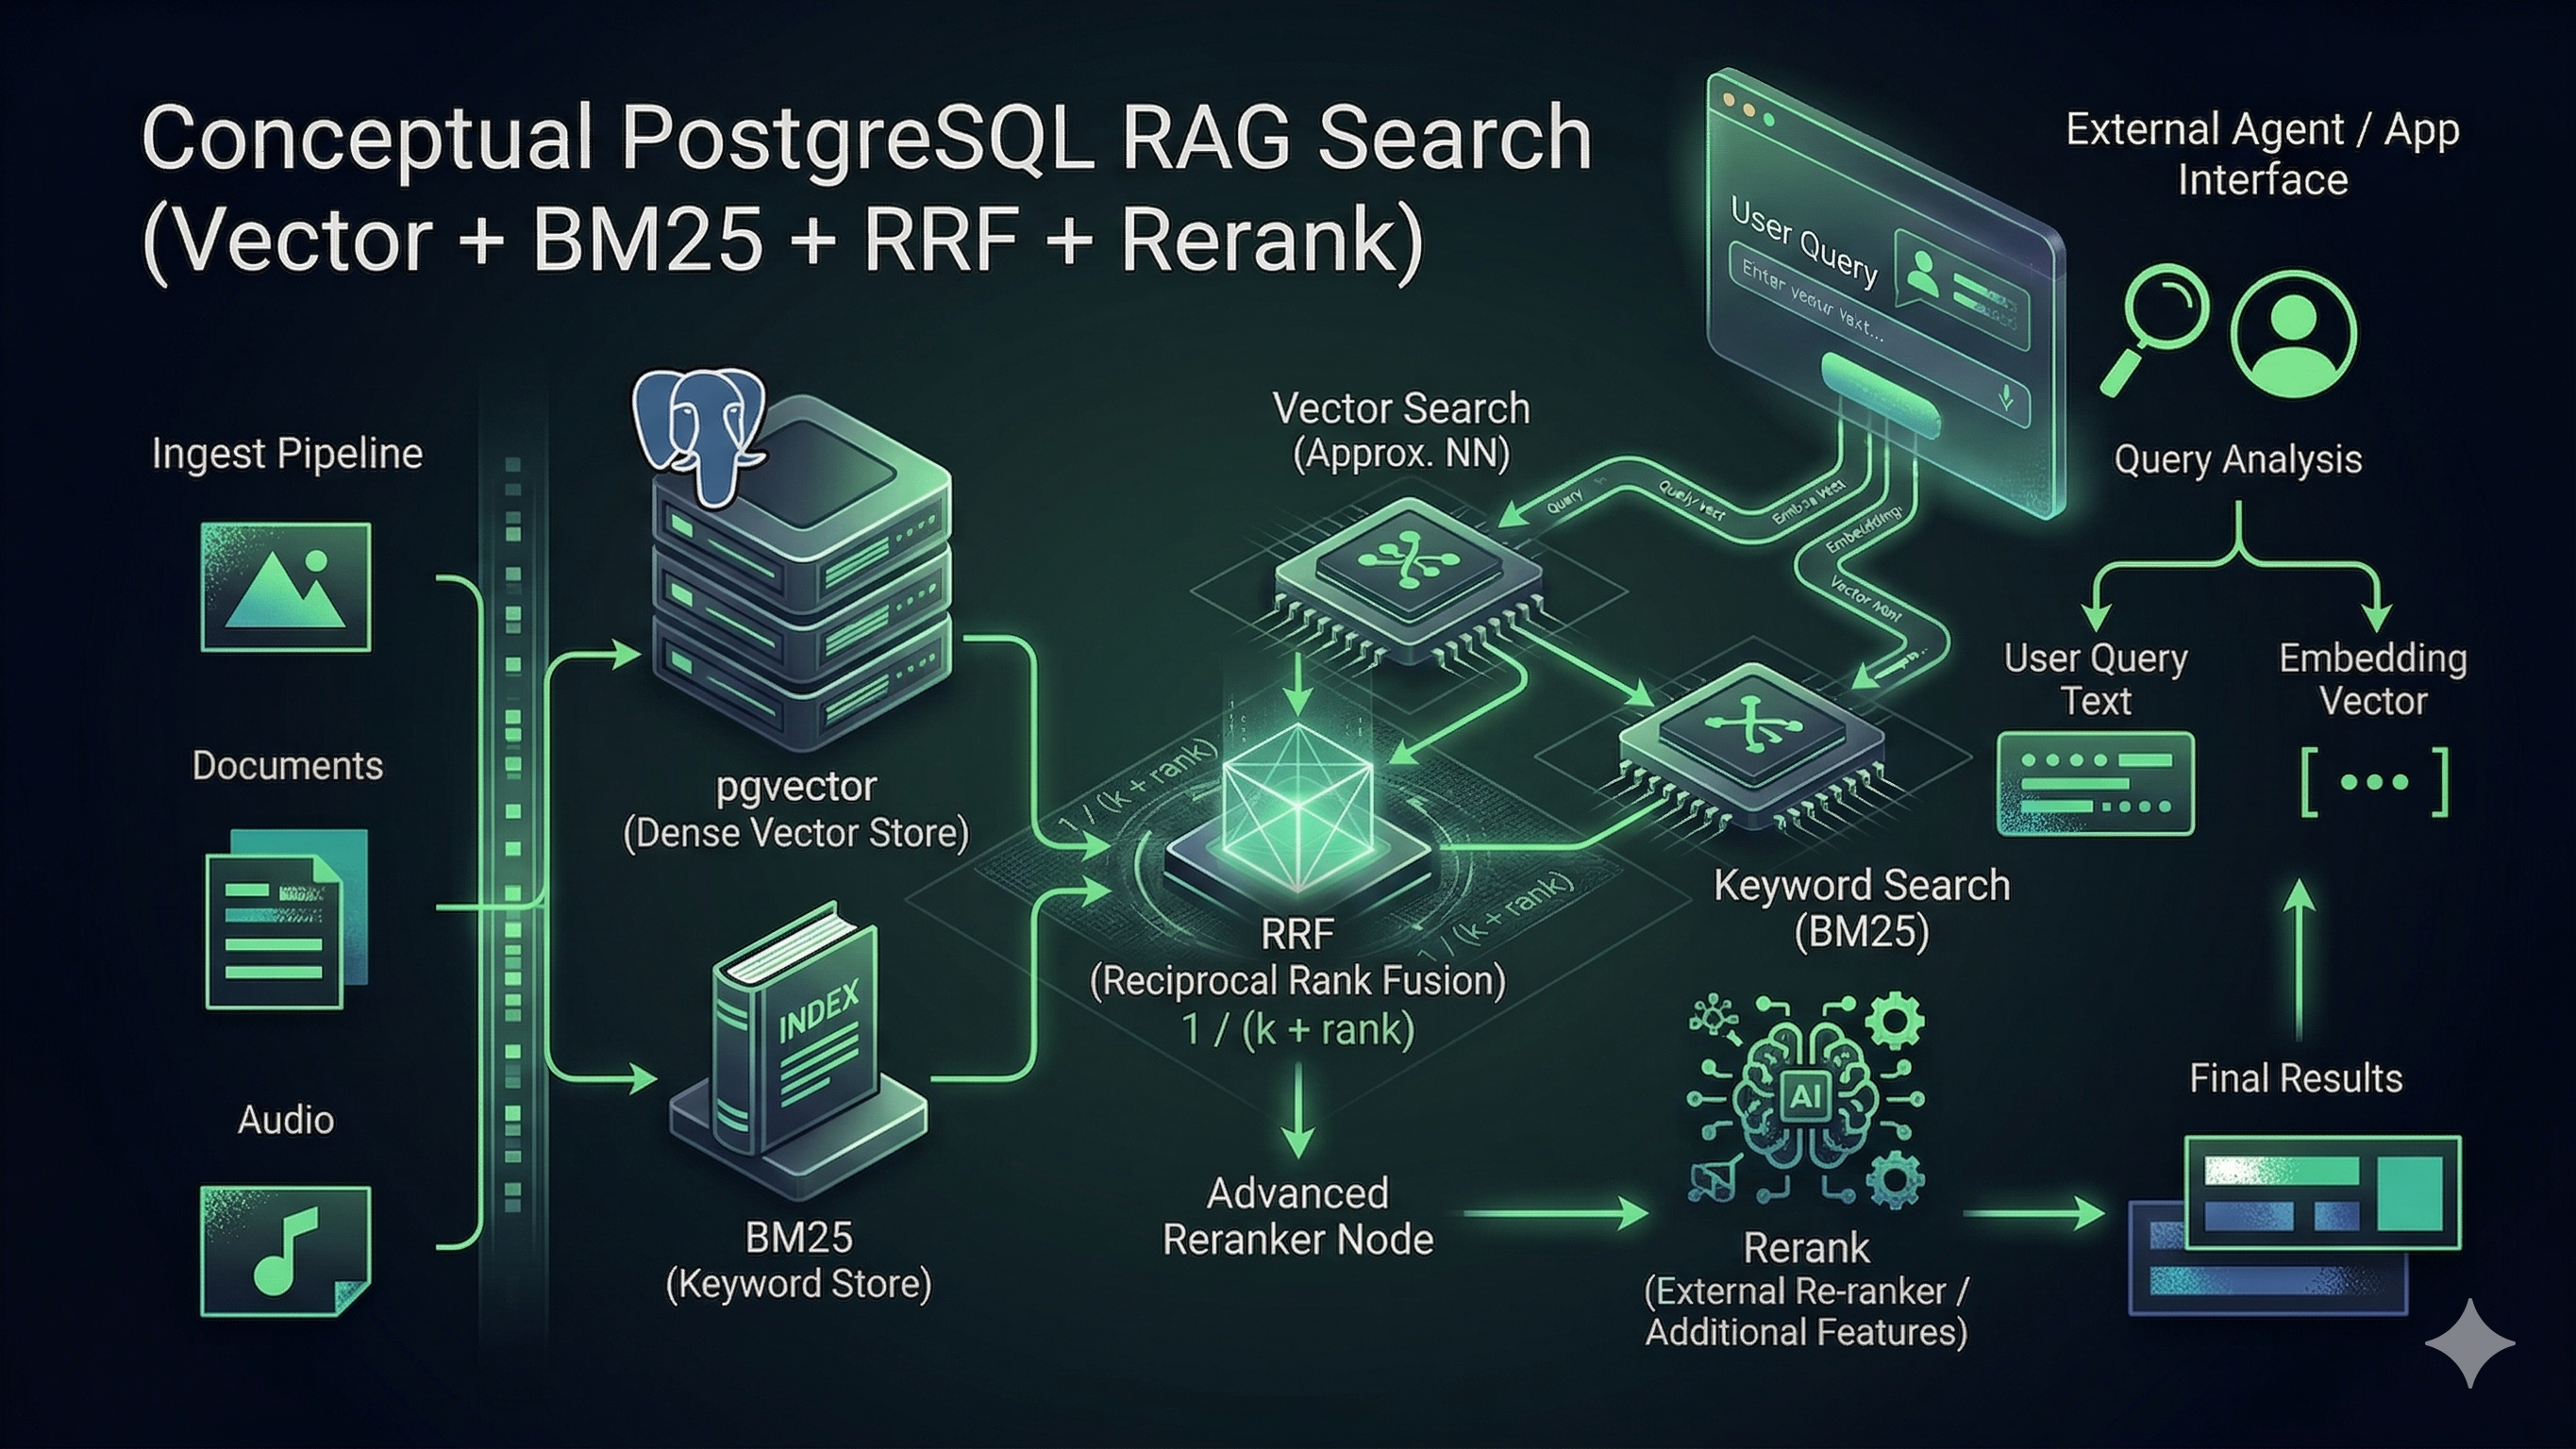
Search
Pipeline
각 검색 방식이 서로 다른 강점을 가지기 때문에, 파이프라인은 병렬 검색 → 점수 통합 → 정밀 재정렬 3단계로 구성했습니다.
• Hybrid Search: Vector(의미 유사도) + BM25(키워드 정확도) + Graph(관계 탐색)를 병렬 실행하여 각 방식의 누락을 상호 보완
• RRF Fusion: 이질적인 점수 체계를 순위 기반으로 통합 (k=60), 스케일 차이 문제 해소
• FlashRank: Cross-Encoder로 최종 재정렬하여 실제 질문-문서 관련성 기준 정밀도 확보
LangGraph 워크플로우로 각 단계를 연결하여 검색 흐름을 제어합니다.
Troubleshooting 1 | 적재 경쟁 조건 (100건 제한이 105건으로)
상황: 사내 문서를 대량으로 등록할 때, 100건씩 나눠 넣도록 제한했는데 동시 워커가 돌면 실제로는 105건이 들어가는 등 데이터 정합성이 깨졌습니다.
판단: 원인은 동시 워커의 check-then-insert 경쟁 조건(개수 확인과 삽입 사이의 간극)이라 판단. 병렬 처리 속도보다 데이터 정합성이 우선이므로 적재 배치를 직렬화하기로 결정했습니다.
액션: PostgreSQL advisory lock으로 적재 배치를 직렬화하고, 충돌 시 지수 백오프 재시도 로직을 적용했습니다.
결과: 적재 초과가 재발 0건으로 사라졌고, 대량 문서 등록 시에도 정합성이 보장되는 안정적인 인덱싱 파이프라인을 확보했습니다.
Troubleshooting 2 | VectorChord 특수 문법
상황: 대용량 벡터 검색 성능 최적화를 위해 VectorChord와 RaBitQ 인덱스를 도입했으나, 표준 pgvector와 다른 특수 연산자(<=>)와 타입(bm25vector)을 사용해 기존 코드와 호환이 되지 않았습니다.
판단: VectorChord의 성능 이점(RaBitQ 양자화 기반 고속 검색)이 마이그레이션 비용보다 크다고 판단. 호환성 문제를 코드 레벨에서 해결하기로 결정했습니다.
액션: search_path에 bm25_catalog, tokenizer_catalog를 포함하고, 전용 SQL 패턴을 문서화하여 일관된 쿼리 작성 방식을 확립했습니다.
결과: VectorChord 전환이 완료되어 대용량 벡터 검색 성능이 최적화되었고, 문서화된 패턴 덕분에 이후 유지보수에서도 혼선 없이 운영할 수 있었습니다.
Key Algorithms | 핵심 알고리즘
• Vector Search: Cosine Distance (1 - distance = similarity)
• BM25 Search: Bert 토크나이저 기반 키워드 검색
• Graph Search: 관계 기반 문서 탐색
• RRF Fusion: Score = Σ(1 / (k + rank)), k=60
• FlashRank: ms-marco-MiniLM-L-12-v2 Cross-Encoder
What I Learned | 배운 점
• 검색 설계 관점: Vector 단독 검색의 키워드 누락, BM25 단독의 의미 누락을 직접 겪으며 하이브리드 검색이 '선택'이 아닌 '필수'임을 체감
• 동시성 제어: 적재 경쟁 조건을 advisory lock으로 직렬화해 해결하며, 성능 최적화보다 데이터 정합성을 먼저 확보해야 한다는 원칙을 학습
• 문서 전처리의 중요성: OCR-LLM, Office to md 변환 없이는 비정형 문서가 RAG 검색 대상에서 빠지며, 전처리 품질이 곧 검색 품질임을 확인
• 2중 신뢰도 설계: RAG 검색 + LLM 직접 읽기 병행으로 단일 경로 의존 리스크를 줄이는 아키텍처 패턴을 습득